
Respuesta breve
Los equipos pequeños ganan más con unos pocos flujos de trabajo de IA gobernados que dando a cada empleado un conjunto inconexo de herramientas.
Idea central: pocos flujos de IA gobernados rinden más que muchas herramientas sueltas
A un equipo pequeño le rinde más contar con unos pocos flujos de trabajo de IA gobernados que entregar a cada empleado un juego de herramientas sin conexión entre sí.
La mayoría de los equipos pequeños no decidieron adoptar la IA. Descubrieron que la habían adoptado unos meses después, cuando un cliente preguntó de dónde había salido un párrafo concreto y nadie supo responder. La proliferación de herramientas en una empresa de diez personas no parece un fallo de compras; parece iniciativa. Cada elección individual fue razonable, y el conjunto es un flujo de trabajo que nadie diseñó, del que nadie se hace cargo y que nadie sabe describir de principio a fin.
Tiempo de ciclo y resultados aceptados: qué cambió y por qué importa ahora
La señal delatora es la reconstrucción. Pida a un equipo que reproduzca un trabajo de hace tres semanas, con las mismas entradas y el mismo resultado, y observe qué ocurre. En los equipos sin un modelo gobernado, la respuesta pasa por localizar a la persona, confiar en que recuerde el prompt y aceptar que la versión del modelo ya es otra. No es un riesgo hipotético. Se vuelve concreto la primera vez que un cliente impugna un entregable, un regulador pregunta por una decisión o un empleado se marcha llevándose el único conocimiento práctico de un flujo de trabajo que ahora sostiene parte del negocio.
Un flujo de bajo riesgo y una lista de aceptación: así se construye el modelo operativo
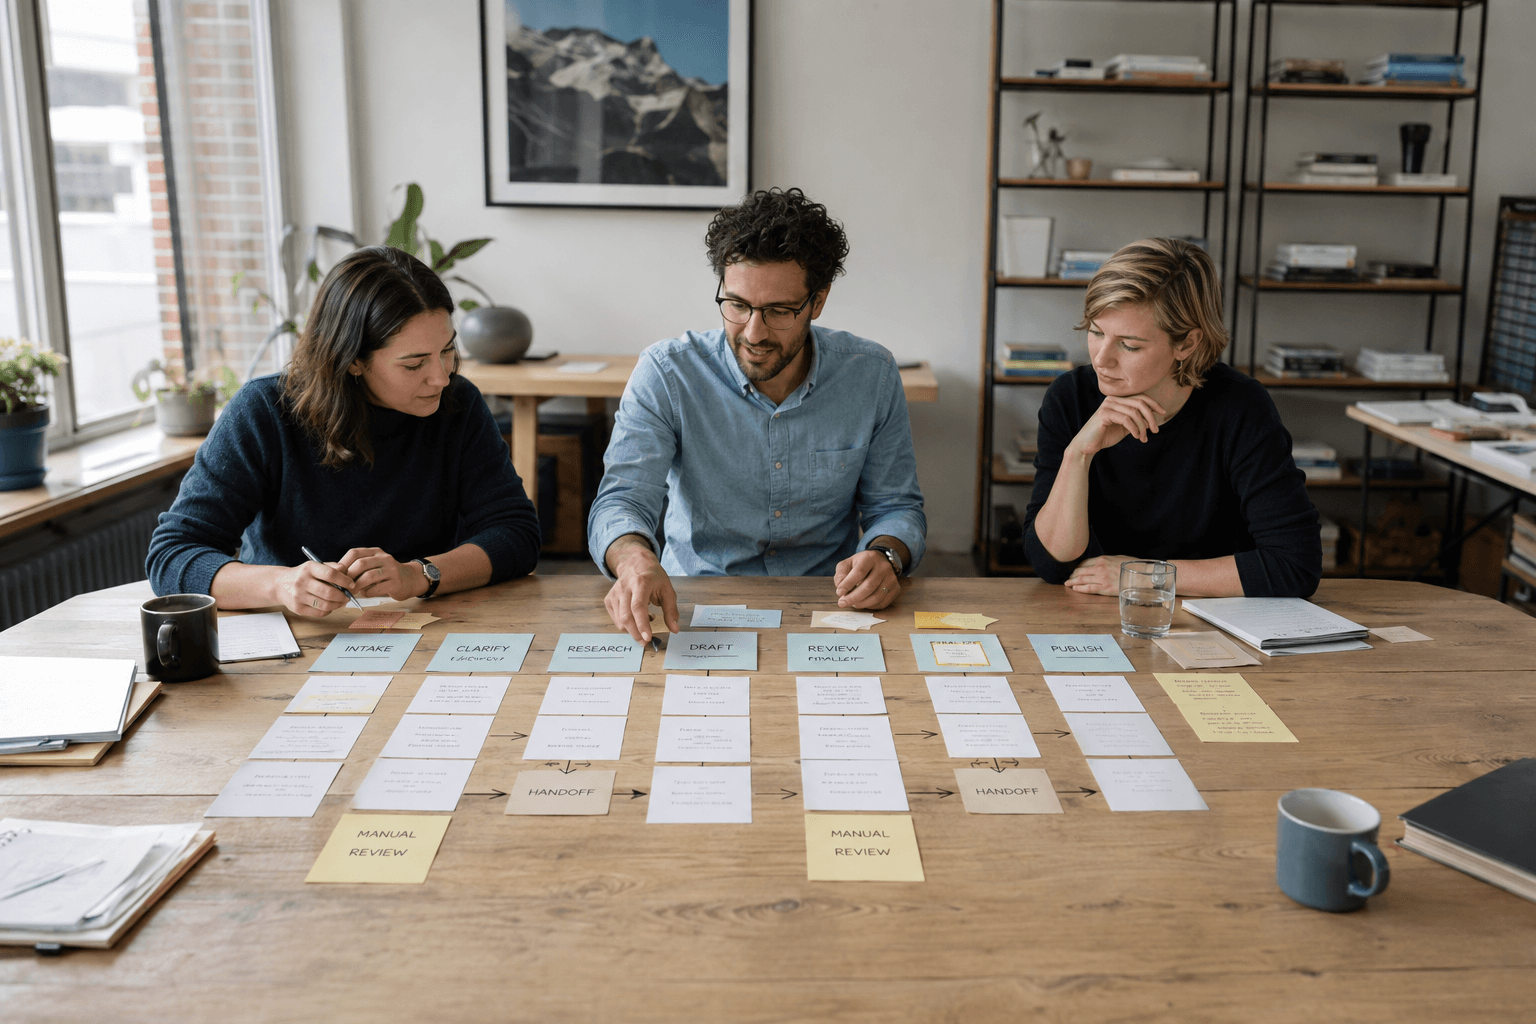
Trace un mapa del trabajo repetible, defina las entradas aceptadas, designe a una persona responsable, registre las versiones del modelo y del prompt y exija una revisión en el punto en que un error saldría caro.
Versione el prompt igual que versiona el código, porque eso es lo que es. Un prompt que produce resultados fiables es un artefacto con un historial de cambios, un responsable y una prueba: un pequeño conjunto de entradas cuyas salidas correctas ya conoce. Cuando el modelo se actualice, y lo hará sin preguntar, esa prueba marcará la diferencia entre detectar una regresión y entregarla. Los equipos que se saltan este paso suelen descubrir el cambio por un cliente y no por una comprobación.
Cuánta IA usar no es la pregunta: mida lo que produjo la decisión
Haga seguimiento del tiempo de ciclo, de la proporción de resultados aceptados, de lo que cuesta corregir, de los incidentes y de qué porcentaje de ejecuciones tiene entradas trazables. Unas horas ahorradas sin pruebas de calidad son un dato incompleto.
La tasa de resultados aceptados es la cifra que no se deja maquillar. Las horas ahorradas las declara cada cual y resultan halagadoras; el coste de corrección es real, pero llega con retraso. La proporción de resultados que salen a la primera, sin una edición sustancial, indica si el flujo de trabajo soporta una carga real o si una persona lo está reescribiendo todo en silencio y llamándolo revisión. Si esa tasa es baja y estable, la conclusión honesta es que el flujo no ahorra nada y, encima, ha añadido una carga de revisión.
Flujos gobernados frente a herramientas sueltas: dónde se rompe la ejecución
La automatización se extiende más deprisa que la rendición de cuentas. Los datos sensibles entran en herramientas no aprobadas, los resultados débiles se convierten en material de partida y nadie puede reconstruir cómo se produjo una decisión.
El segundo fallo es más silencioso y más difícil de revertir: el resultado débil que se convierte en material de partida. Un resumen generado por un modelo se pega en un informe, el informe orienta una decisión, la decisión se pone por escrito y, seis meses después, la incertidumbre original ha quedado blanqueada como un hecho interno sin cita alguna. Nada en esa cadena fue deshonesto. La procedencia simplemente se evaporó, un paso razonable tras otro, y ahora la organización cree algo que no puede comprobar.
Unos pocos flujos de IA gobernados: cómo se ve en la práctica
En un equipo pequeño esto rara vez es una plataforma. Es un documento compartido por cada flujo de trabajo gobernado, en el que constan el responsable, el modelo y su versión, el prompt con su historial de cambios, las cinco entradas de prueba y el punto de revisión. Cabe en una página. La disciplina está en mantenerlo al día y no en la sofisticación del formato, y la señal honesta de que el modelo funciona es que alguien distinto del autor pueda ejecutar el flujo correctamente al primer intento, sin hacer una sola pregunta. Si eso falla, el documento describe una intención y no un proceso.
Menos herramientas y más gobernanza: el argumento más fuerte en contra
La objeción de peso es que la gobernanza a esta escala es prematura y cara. Un equipo de diez personas que documenta versiones de prompts y mantiene pruebas de regresión está dedicando el tiempo de su gente más sénior al proceso y no al resultado, y los procesos tienden a sobrevivir a su utilidad. La objeción tiene fuerza real: el modelo descrito arriba no es el adecuado para un equipo que todavía está descubriendo qué flujos importan, e imponerlo pronto producirá un cumplimiento de cara a la galería. Lo que debe activar su adopción no es el tamaño de la plantilla, sino la consecuencia, y el primer flujo cuyo fallo llegaría a un cliente es el que necesita un responsable.
Una complicación adicional es que la frontera se mueve. Un flujo que empieza como una comodidad interna a menudo acaba de cara al cliente sin que nadie lo haya decidido, porque funcionó bien y alguien reutilizó el resultado. Esa deriva es la vía más común por la que el trabajo sin gobierno llega a un cliente, y ningún inventario hecho en un único momento la detectará. La respuesta práctica es revisar el inventario con una cadencia fija y no cuando se tenga la impresión de que algo ha cambiado, porque para entonces ya ha cambiado.
Resultados aceptados y coste de corrección: secuencia de implantación en 30 días
Escoja un único flujo de bajo riesgo que tenga volumen cada semana, redacte su lista de comprobación de aceptación y, durante cuatro semanas, hágalo también a mano en paralelo al proceso de IA.
Primera semana: inventaríe lo que ya está en marcha —cada herramienta en uso, quién la usa y qué datos han pasado por ella—. Segunda semana: elija el único flujo cuyo fallo sería más visible desde fuera y asígnele un responsable, un prompt versionado y cinco entradas de prueba. Tercera semana: ejecútelo contra esas pruebas y registre con honestidad la tasa de resultados aceptados. Cuarta semana: decida si extiende el modelo a un segundo flujo o retira el primero, y deje por escrito cuál de las dos cosas y por qué.
Defina cómo se gestiona un incidente antes de que el flujo cobre importancia
El plan de incidentes útil más pequeño cabe junto al registro del flujo de trabajo. Indique qué cuenta como fallo relevante, quién puede detener el proceso, dónde se conservan la entrada y la salida, cómo se informa al cliente o al compañero afectado y qué evidencia se exige antes de reanudar el flujo. Incluya fallos que parecen corrientes: una cita inventada, un campo confidencial copiado en la herramienta equivocada, un cambio de tono que sobrevive a la revisión o una actualización del modelo que altera una clasificación repetida. Un equipo que espera un suceso dramático pasará por alto los fallos más discretos, los que se convierten en material de partida y viajan a decisiones posteriores. El plan es valioso precisamente porque convierte el acto de parar en una rutina y no en una cuestión de reputación.
Ejecute las cinco entradas de referencia después de cada cambio de modelo, de prompt, de recuperación de información, de política o de fuente de datos, y al menos una vez al mes cuando nada parezca cambiar. Registre la tasa de resultados aceptados, las correcciones sustanciales, el tiempo del revisor y cualquier caso en que la persona no haya podido reconstruir el origen de una afirmación. Cada trimestre, pregúntese si el flujo sigue perteneciendo a su clase de riesgo original: la redacción de borradores internos puede derivar en comunicación con clientes sin un lanzamiento formal. Si la consecuencia ha cambiado, los controles deben cambiar antes de la siguiente ejecución. Si el resultado no supera la referencia manual tras un periodo de revisión definido, retírelo abiertamente en lugar de conservar la automatización por la automatización misma.
Conclusión editorial: cuánta IA usa un equipo pequeño no es la pregunta útil
La pregunta útil no es cuánta IA debería usar un equipo pequeño. Es qué resultados está dispuesto a defender el equipo y qué evidencia existe para defenderlos. Un flujo de trabajo gobernado, con un responsable designado y una entrada reproducible, es defendible a cualquier escala. Uno sin gobierno es un pasivo que crece en silencio, en proporción a lo bien que parece estar funcionando.
Lista práctica
- Primer paso: elija un flujo de trabajo de bajo riesgo con volumen semanal, escriba una lista de comprobación de aceptación y ejecútelo a mano junto al proceso de IA durante cuatro semanas.
- Qué medir: el tiempo de ciclo, la tasa de resultados aceptados, el coste de corrección, los incidentes y el porcentaje de ejecuciones con entradas trazables.
- Fallo que conviene vigilar: la automatización se extiende más deprisa que la rendición de cuentas.
- Asigne un responsable visible y una fecha de revisión. La pregunta útil no es cuánta IA debería usar un equipo pequeño.
- Separe la evidencia de la interpretación. Los equipos pequeños ganan más con unos pocos flujos de trabajo de IA gobernados que con un conjunto inconexo de herramientas para cada empleado.
- Registre una línea de base antes de cambiar el proceso. Unos pocos flujos de IA gobernados dan más a un equipo pequeño que las herramientas inconexas repartidas a cada empleado.
Preguntas frecuentes
¿Por dónde debe empezar un equipo pequeño a montar su modelo operativo de IA?
Elija un solo flujo de trabajo de bajo riesgo y con volumen semanal, prepare una lista de comprobación de aceptación y, durante cuatro semanas, ejecútelo manualmente al lado del proceso de IA.
¿Qué deben medir los responsables en un modelo operativo de IA para equipos pequeños?
Controle el tiempo de ciclo, la tasa de resultados aceptados, el coste de corrección, los incidentes y el porcentaje de ejecuciones cuyas entradas pueden rastrearse. Sin evidencia de calidad, las horas ahorradas son una cifra incompleta.
¿Cuál es el principal riesgo de ejecución cuando un equipo pequeño trabaja con IA?
La automatización avanza más rápido que la rendición de cuentas. Datos sensibles acaban en herramientas sin aprobar, un resultado débil pasa a ser material de partida y nadie es capaz de reconstruir cómo se llegó a una decisión.
¿Cuánto debe durar el primer piloto de un flujo de trabajo de IA gobernado?
Cuatro semanas suelen bastar para sacar a la luz las lagunas del flujo de trabajo sin convertir el piloto en una ambigüedad permanente. Juzgue el piloto por la medida que importa aquí. Siga el tiempo de ciclo, la tasa de resultados aceptados, el coste de corrección, los incidentes y el porcentaje de ejecuciones con entradas trazables.
¿Quién debe ser responsable de los flujos de trabajo de IA en un equipo pequeño?
Un operador designado es responsable del flujo de trabajo, y el directivo que responde del negocio lo es de la decisión y de la cadencia de revisión. El flujo en sí es el descrito en el artículo. Trace un mapa del trabajo repetible, defina las entradas aceptadas, designe a una persona responsable, registre las versiones del modelo y del prompt y exija una revisión allí donde un error saldría caro.