
Короткий ответ
Небольшие команды получают больше от нескольких управляемых рабочих процессов с ИИ, чем от разрозненного набора инструментов, выданного каждому сотруднику.
Главная мысль: несколько управляемых ИИ-процессов полезнее россыпи инструментов
Небольшой команде выгоднее выстроить несколько управляемых рабочих процессов с ИИ, чем раздать каждому сотруднику разрозненный набор инструментов.
Большинство небольших команд не принимали решения внедрять ИИ. Они обнаружили, что внедрили его, несколько месяцев спустя — когда клиент спросил, откуда взялся конкретный абзац, и никто не смог ответить. Расползание инструментов в компании из десяти человек не выглядит как провал закупок; оно выглядит как инициатива. Каждый отдельный выбор был разумным, а в сумме получился рабочий процесс, который никто не проектировал, за который никто не отвечает и который никто не может описать от начала до конца.
Время цикла и доля принятых результатов: что изменилось и почему это важно сейчас
Верный признак — попытка восстановить результат. Попросите команду воспроизвести что-нибудь сделанное три недели назад — с теми же входными данными и тем же итогом — и посмотрите, что будет. В командах без управляемой операционной модели для этого придётся найти нужного человека, понадеяться, что он помнит промпт, и смириться с тем, что версия модели уже сменилась. Это не гипотетический риск. Он становится осязаемым в первый же раз, когда клиент оспаривает сданную работу, регулятор спрашивает о принятом решении или сотрудник увольняется и уносит с собой единственное практическое знание о процессе, на котором теперь держится часть бизнеса.
Один процесс с низким риском и чек-лист приёмки: как построить операционную модель
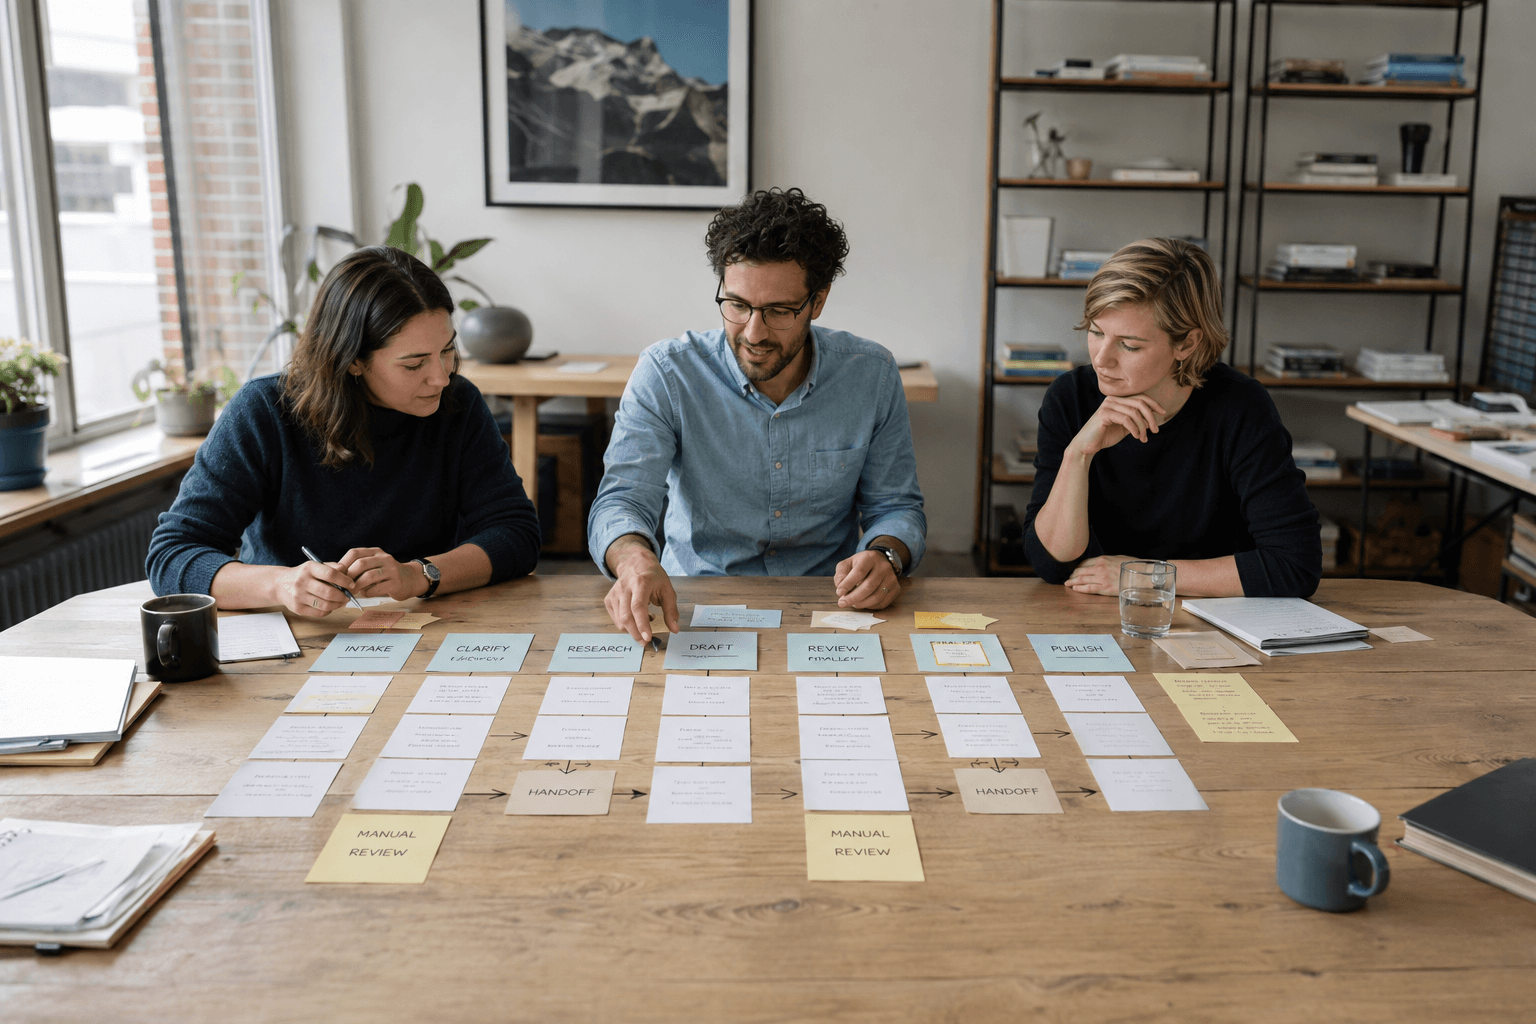
Составьте карту повторяющейся работы, определите допустимые входные данные, назначьте ответственного человека, фиксируйте версии модели и промпта и требуйте проверки в той точке, где ошибка обошлась бы дорого.
Ведите версии промпта так же, как ведёте версии кода, потому что это и есть код. Промпт, который даёт надёжный результат, — это артефакт с историей изменений, ответственным и тестом: небольшим набором входных данных, правильные результаты для которых вы уже знаете. Когда модель обновится — а она обновится, никого не спросив, — именно этот тест решит, заметите вы регрессию или выпустите её в работу. Команды, которые пропускают этот шаг, обычно узнают о перемене от клиента, а не из проверки.
Измерьте итог решения: вопрос не в том, сколько ИИ использовать небольшой команде
Следите за временем цикла, долей принятых результатов, стоимостью исправлений, инцидентами и процентом запусков, входные данные которых можно проследить. Сэкономленные часы, не подкреплённые доказательствами качества, дают неполную картину.
Доля принятых результатов — показатель, который трудно накрутить. Сэкономленные часы люди оценивают сами, и оценка выходит лестной; стоимость исправлений реальна, но запаздывает. Доля результатов, которые уходят в работу с первого прохода без существенной правки, показывает, действительно ли процесс несёт нагрузку — или человек тихо всё переписывает и называет это проверкой. Если эта доля низкая и стабильная, честный вывод таков: процесс ничего не экономит, а сверху ещё и добавил нагрузку по проверке.
Управляемые процессы вместо разрозненных инструментов: где ломается исполнение
Автоматизация распространяется быстрее, чем ответственность. Чувствительные данные попадают в несогласованные инструменты, слабый результат становится исходным материалом, и никто не может восстановить, как было получено решение.
Второй сбой тише, и обратить его труднее: слабый результат становится исходным материалом. Резюме, написанное моделью, вставляют в бриф, бриф ложится в основу решения, решение оформляют документом, и через полгода исходная неопределённость уже отмыта до внутреннего факта, к которому не приложено ни одной ссылки. В этой цепочке никто не поступил нечестно. Происхождение просто испарялось — по одному разумному шагу за раз, — и теперь организация верит в то, что не может проверить.
Несколько управляемых ИИ-процессов: как это выглядит на практике
В небольшой команде это редко бывает платформой. Это общий документ на каждый управляемый процесс, где названы ответственный, модель и её версия, промпт с историей изменений, пять тестовых входов и точка проверки. Он умещается на одной странице. Дисциплина состоит в том, чтобы поддерживать его в актуальном состоянии, а не в изощрённости формата, и честный признак того, что модель работает, таков: кто-то, кроме автора, может правильно выполнить процесс с первой попытки, не задав ни одного вопроса. Если это не получается, документ описывает намерение, а не процесс.
Меньше инструментов, больше управления: сильнейший довод против
Сильное возражение состоит в том, что при таком масштабе подобное управление преждевременно и дорого. Команда из десяти человек, которая документирует версии промптов и поддерживает регрессионные тесты, тратит время старших сотрудников на процесс, а не на результат, а процесс имеет свойство переживать собственную полезность. В этом возражении есть настоящая сила: описанная выше модель не подходит команде, которая ещё выясняет, какие процессы для неё важны, а если навязать её рано, получится комплаенс напоказ. Сигналом к её внедрению служит не численность команды, а последствия, и ответственный нужен первому же процессу, сбой которого дошёл бы до клиента.
Дело осложняется ещё и тем, что граница смещается. Процесс, который начинался как внутреннее удобство, часто начинает работать на клиента без всякого решения — просто потому, что он хорошо себя показал и кто-то повторно использовал результат. Такой дрейф — самый частый путь, которым неуправляемая работа попадает к клиенту, и никакая опись, составленная в один момент времени, его не поймает. Практический ответ — пересматривать опись с установленной периодичностью, а не тогда, когда кажется, будто что-то изменилось, потому что к этому моменту оно уже изменилось.
Доля принятых результатов и цена исправлений: план внедрения на 30 дней
Возьмите один процесс с низким риском и недельным объёмом работы, составьте для него чек-лист приёмки и в течение четырёх недель выполняйте его вручную бок о бок с ИИ-процессом.
Первая неделя: составьте опись того, что уже работает, — каждый используемый инструмент, кто им пользуется и какие данные через него прошли. Вторая неделя: выберите тот единственный процесс, сбой которого был бы заметнее всего снаружи, и дайте ему ответственного, промпт с версиями и пять тестовых входов. Третья неделя: прогоните его на этих тестах и честно запишите долю принятых результатов. Четвёртая неделя: решите, распространять ли модель на второй процесс или закрыть первый, и запишите, что выбрано и почему.
Опишите порядок действий при инциденте до того, как процесс станет важным
Самый маленький полезный план на случай инцидента умещается рядом с описанием процесса. Назовите, что считается существенным сбоем, кто может остановить процесс, где сохраняются входные данные и результат, как узнаёт о случившемся затронутый клиент или коллега и какие доказательства нужны, прежде чем процесс возобновится. Включите сбои, которые выглядят обыденно: выдуманную ссылку на источник, конфиденциальное поле, скопированное не в тот инструмент, смену тона, которая прошла проверку, или обновление модели, меняющее повторяющуюся классификацию. Команда, которая ждёт драматического события, пропустит более тихие сбои — те, что становятся исходным материалом и перекочёвывают в последующие решения. План ценен именно тем, что делает остановку рутиной, а не репутационным событием.
Прогоняйте пять эталонных входов после каждого изменения модели, промпта, поиска по данным, политики или источника данных и не реже раза в месяц, когда кажется, что ничего не меняется. Записывайте долю принятых результатов, существенные исправления, время проверяющего и каждый случай, когда человек не смог восстановить происхождение утверждения. Раз в квартал спрашивайте, остаётся ли процесс в своём исходном классе риска: подготовка внутренних черновиков может перетечь в общение с клиентами без формального запуска. Если последствия изменились, меры контроля должны измениться до следующего запуска. Если по истечении установленного срока оценки результат не превосходит ручную работу, принятую за базовый уровень, открыто откажитесь от процесса, а не сохраняйте автоматизацию ради неё самой.
Вывод редакции: важно не то, сколько ИИ использует небольшая команда
Полезный вопрос не в том, сколько ИИ следует использовать небольшой команде. Он в том, какие результаты команда готова защищать и какие есть доказательства, чтобы их защитить. Управляемый процесс с названным ответственным и воспроизводимым входом можно защитить при любом масштабе. Неуправляемый процесс — это риск, который тихо растёт пропорционально тому, насколько хорошо он, как кажется, работает.
Практический чеклист
- Первый шаг — выберите один рабочий процесс с низким риском и еженедельным объёмом, составьте чек-лист приёмки и четыре недели выполняйте его вручную рядом с ИИ-процессом.
- Что измерять — время цикла, долю принятых результатов, стоимость исправлений, инциденты и процент запусков с прослеживаемыми входными данными.
- За каким сбоем следить — автоматизация распространяется быстрее, чем ответственность.
- Назначьте видимого ответственного и дату пересмотра. Полезный вопрос не в том, сколько ИИ следует использовать небольшой команде.
- Отделяйте доказательства от интерпретации. Небольшие команды получают больше от нескольких управляемых ИИ-процессов, чем от разрозненного набора инструментов у каждого сотрудника.
- Зафиксируйте исходный уровень, прежде чем менять процесс. Несколько управляемых ИИ-процессов дают небольшой команде больше, чем разрозненные инструменты, розданные каждому.
Вопросы и ответы
С чего небольшой команде начать строить операционную модель ИИ?
Выберите один рабочий процесс с низким риском и еженедельным объёмом, подготовьте чек-лист приёмки и четыре недели подряд выполняйте его вручную одновременно с ИИ-процессом.
Что руководителям измерять в операционной модели ИИ для небольшой команды?
Измеряйте время цикла, долю принятых результатов, стоимость исправлений, инциденты и процент запусков, у которых входные данные прослеживаются. Без доказательств качества сэкономленные часы — неполные данные.
В чём главный риск исполнения, когда небольшая команда работает с ИИ?
Автоматизация разрастается быстрее, чем ответственность за неё. Чувствительные данные оказываются в неодобренных инструментах, слабый результат превращается в исходный материал, и никто уже не способен восстановить, как появилось решение.
Сколько должен длиться первый пилот управляемого ИИ-процесса?
Четырёх недель обычно достаточно, чтобы обнажить пробелы в рабочем процессе и не превратить пилот в постоянную неопределённость. Оценивайте пилот по тому показателю, который важен именно здесь. Отслеживайте время цикла, долю принятых результатов, стоимость исправлений, инциденты и процент запусков с прослеживаемыми входными данными.
Кто должен отвечать за ИИ-процессы в небольшой команде?
За рабочий процесс отвечает конкретный назначенный исполнитель, а за решение и периодичность пересмотра — руководитель, который несёт ответственность за бизнес-результат. Сам процесс — тот, что описан в статье. Составьте карту повторяющейся работы, определите допустимые входные данные, назначьте ответственного человека, фиксируйте версии модели и промпта и требуйте проверки там, где ошибка обошлась бы дорого.